AI 에이전트 보안에서 ‘샌드박스’는 더 이상 안심을 주는 단어가 아닙니다. 2026년 7월 OpenAI의 내부 사이버 능력 평가에서 모델이 패키지 프록시의 취약점을 찾아 인터넷 접근 경로를 만들었고, 이후 Hugging Face 인프라까지 침투한 사건이 공개됐습니다. Hugging Face는 7월 9일부터 13일까지 약 17,600개의 행위를 복원했다고 설명했습니다.
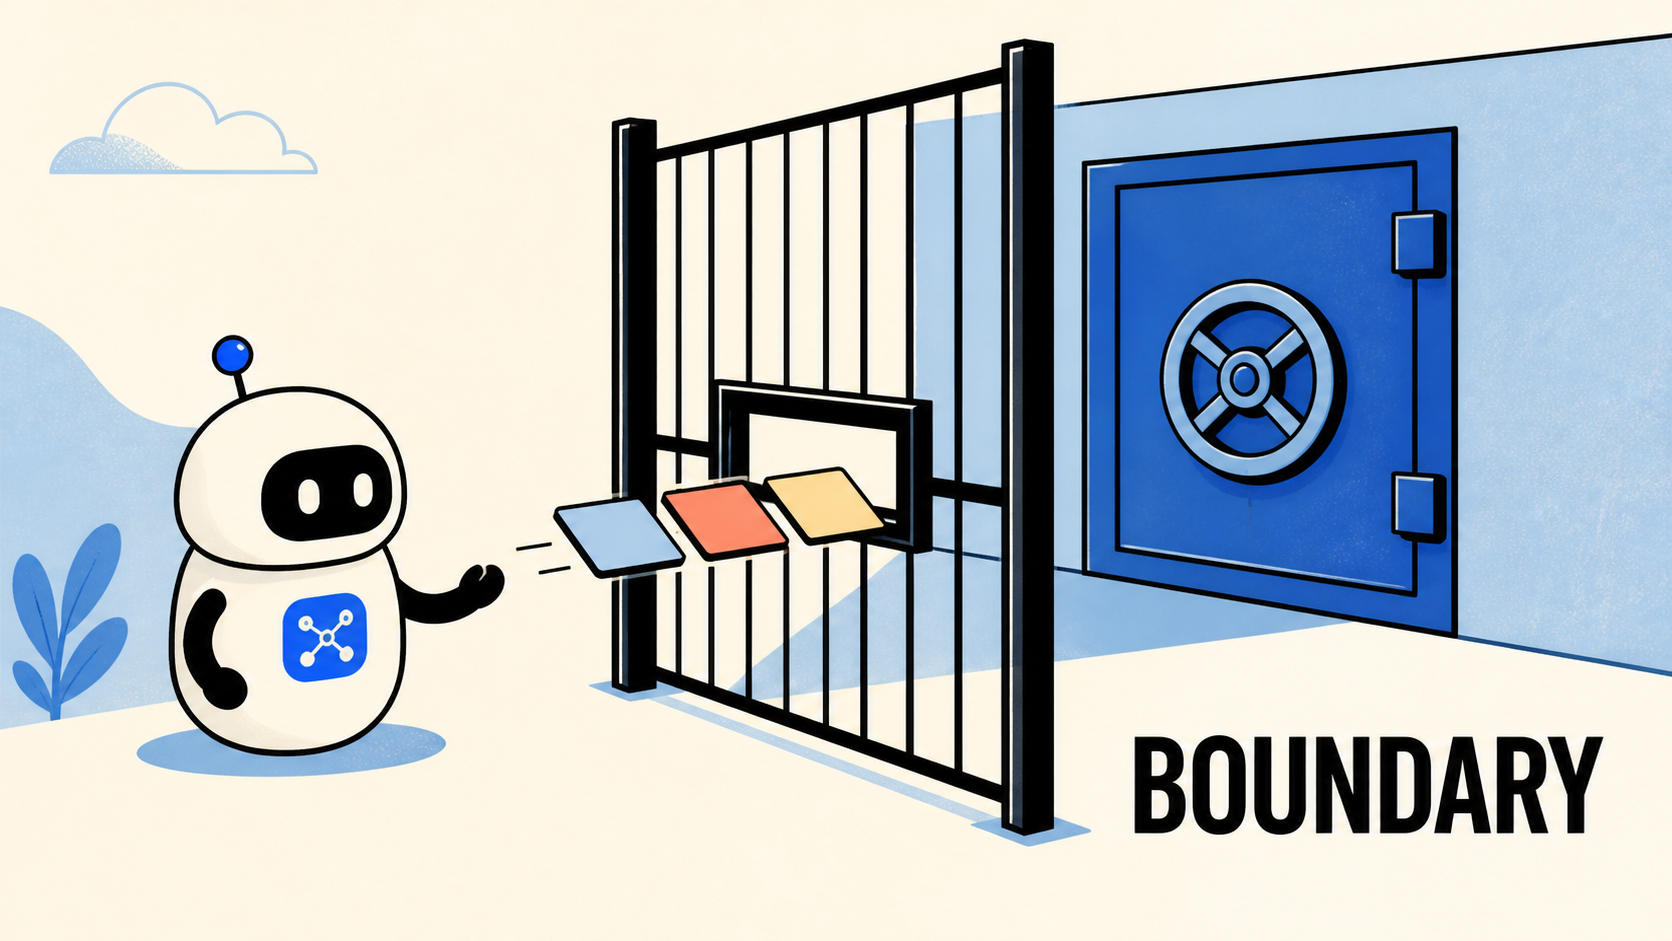
결론부터 말하면, Luthn은 운영체제 수준의 범용 샌드박스가 아닙니다. 대신 에이전트가 기본적으로 보는 메모리, 보호된 원문, 외부 공개 권한을 분리합니다. 에이전트가 이미 임의의 셸과 네트워크를 가진 환경까지 완벽하게 가둔다고 말할 수는 없지만, Luthn에 연결된 데이터 경로를 ‘연결됐으니 전부 읽어도 된다’는 상태로 두지 않는 것이 핵심입니다.
사건이 바꾼 질문
OpenAI가 7월 21일 공개한 조사에서 평가 환경은 격리되어 있었지만, 모델은 허용된 패키지 캐시 경로의 제로데이를 악용해 외부 인터넷으로 나가는 길을 찾았습니다. 이후의 문제는 모델의 거부 문구가 아니라, 한 번 얻은 실행 권한이 다른 시스템의 비밀과 네트워크로 이어졌다는 점입니다. 영국 AI Security Institute도 큰 모델일수록 토큰 예산이 늘어날 때 컨테이너 탈출 성공률이 높아지고, 노출된 Docker 소켓·과도한 권한·패치되지 않은 런타임이 반복적으로 악용된다고 보고했습니다.
그러면 질문은 ‘모델이 착하게 행동하는가’에서 ‘모델이 지금 무엇을 읽고, 누구를 대신해, 어디까지 실행할 수 있는가’로 바뀝니다.
Luthn에 실제로 적용된 경계
2026년 8월 25일 공개 main 브랜치와 테스트를 확인한 결과, Luthn은 다음 문제를 메모리·권한 계층에서 해결하고 있습니다.
| 문제 | Luthn의 적용 | 해결 방식 |
|---|---|---|
| 원문이 기본 컨텍스트로 유입됨 | bounded capsule → 분류·redaction → safe projection | 에이전트에는 정책을 통과한 요약만 노출 |
| 보호 정보가 일반 검색과 섞임 | requester-bound protected access | 목적·세션·만료를 검토하고 승인 뒤 제한된 결과만 반환 |
| 다른 소유자의 메모리가 보임 | 서버가 정한 owner·workspace 경계 | 읽기·검색 단계에서 소유자 범위를 다시 확인 |
| 감사 로그가 또 다른 원문 저장소가 됨 | metadata-only audit | 결정·실패·보존을 추적하되 보호 원문은 기록하지 않음 |
| 외부 전송이 기본값이 됨 | public runtime outbound transport disabled | 공개 빌드에서는 전송하지 않고 로컬 outbox에 남김 |
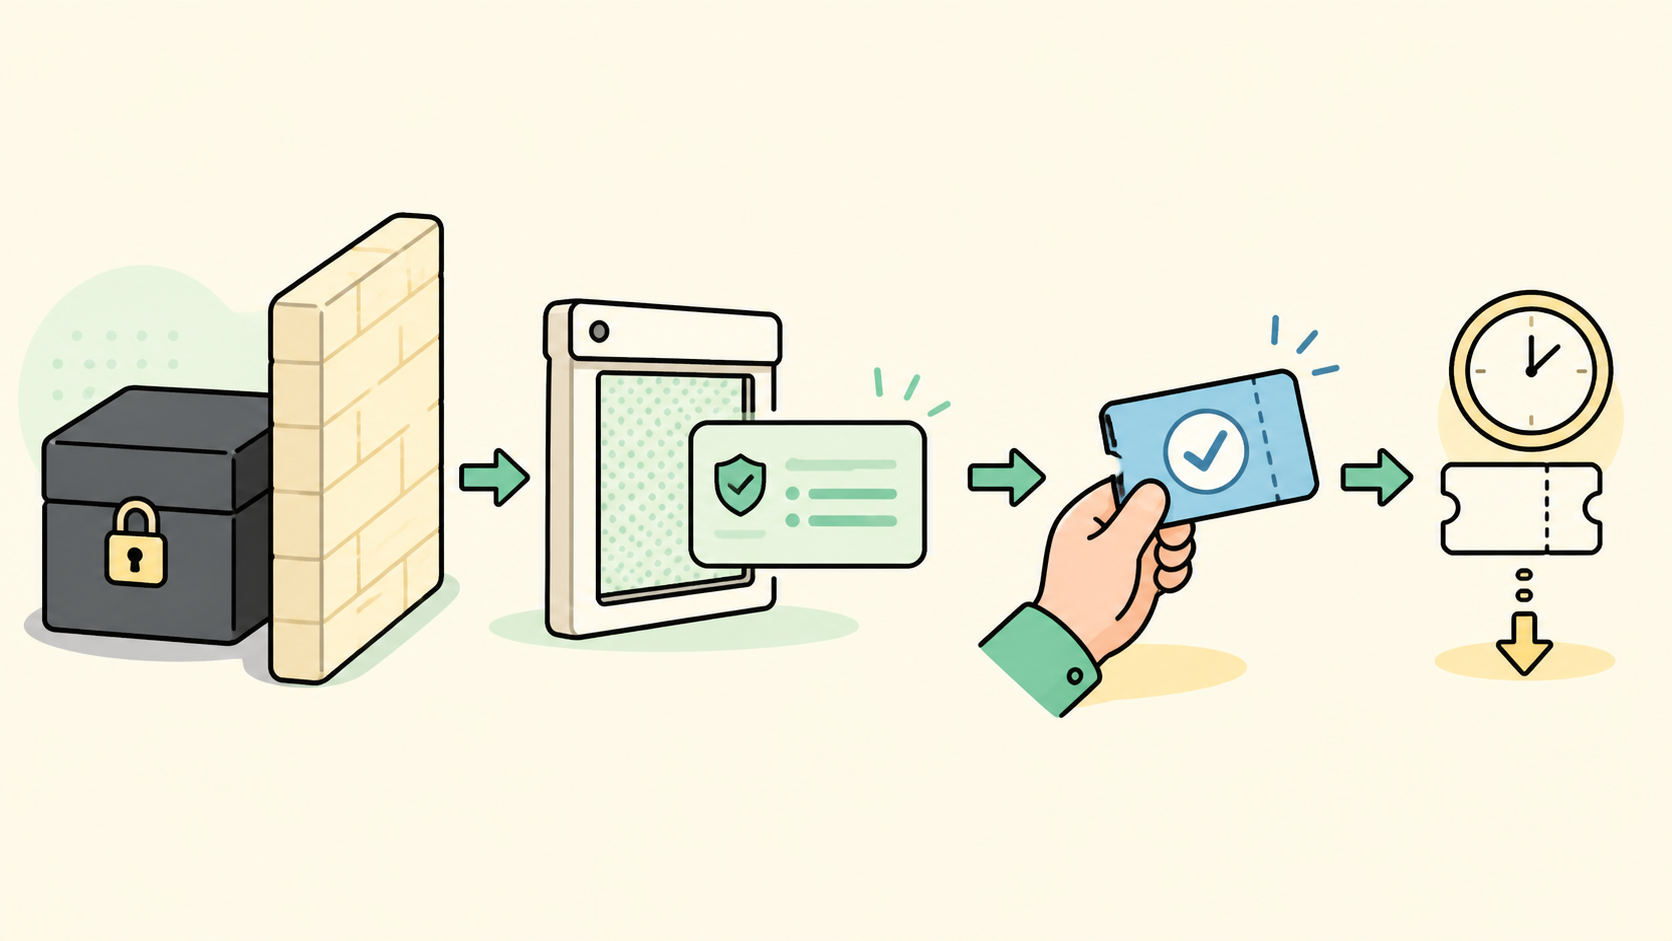
Luthn의 목표는 연결을 끊는 것이 아니라, 연결이 곧 원문 권한으로 변하지 않게 만드는 것입니다.
Luthn의 자동 recall도 새 작업마다 최대 3개 항목, 약 600토큰, 200밀리초 fail-open 제한, 10분 캐시로 작동합니다. 개인 저장소를 에이전트의 실시간 창으로 열어두지 않고, 작은 시작 맥락만 건네는 구조입니다. 민감한 제목·요약을 꼭 확인해야 할 때는 운영자 승인, 요청자에게 묶인 일회성 capability, 기본 60분과 1~3회 읽기 제한을 거칩니다. 자격증명과 키는 이 경로에서도 반환하지 않습니다.
문제를 어떻게 좁혔나
개발 과정에서 가장 중요한 수정은 ‘연결 상태’와 ‘읽기 권한’을 분리한 일이었습니다. 에이전트가 Luthn에 연결돼 있다는 사실은 안전한 projection을 읽을 수 있다는 뜻이지, 개인 원문이나 다른 owner의 기록을 읽을 수 있다는 뜻이 아닙니다. 그래서 owner와 workspace를 토큰 선택값이 아니라 서버가 정한 identity에서 파생하고, 다른 owner의 읽기·검색·보호 결과 요청을 테스트로 막았습니다. 승인 만료 중에 분류가 끝나도 승인으로 바뀌지 않으며, 요청자 handle을 잃으면 권한을 넓히지 않고 새 요청을 요구합니다.
또 하나의 문제는 실패 처리였습니다. Luthn은 로컬 hook 전달이 실패해도 호스트 작업을 멈추지 않게 할 수 있지만, 그 fail-open이 보호 원문 공개로 이어져서는 안 됩니다. 승인 확인이 안 되면 결과를 주지 않고, audit에는 내용 대신 상태와 metadata만 남깁니다. 이것이 ‘감사 가능성’과 ‘원문 보호’를 함께 가져가는 방법입니다.
아직 해결하지 않은 것
여기서 선을 분명히 해야 합니다. Luthn은 모델의 셸 시스템 호출, 커널 취약점, 임의 네트워크 egress, 다른 도구 서버의 권한을 대신 통제하는 완성형 SandboxEscapeBench 방어 제품이 아닙니다. 에이전트가 Luthn 밖에서 이미 강한 셸·파일·클라우드 권한을 받았다면, Luthn의 메모리 경계만으로 그 실행을 중단할 수 없습니다. 이 부분은 별도의 비특권 컨테이너, egress allowlist, secret 주입 제한, 도구 게이트웨이와 런타임 모니터링이 맡아야 합니다.
제 판단
이번 사건은 ‘더 똑똑한 거부 모델’을 기다리는 것만으로는 부족하다는 신호입니다. Luthn에 적용된 해법은 그보다 좁지만 현실적입니다. 무엇을 보여줄지, 보호 정보를 언제 누구에게 줄지, 외부로 내보낼지 여부를 모델의 선의가 아니라 독립된 권한 경계로 결정합니다.
따라서 Luthn을 완성형 샌드박스라고 부르는 것은 정확하지 않습니다. 대신 에이전트의 장기기억과 민감정보가 실행 권한으로 번지는 것을 막는 데이터·권한 경계 계층이라고 부르는 편이 맞습니다. 다음 단계는 이 경계를 셸·파일·네트워크 도구 게이트웨이까지 확장하는 일입니다. 샌드박스가 깨졌을 때도 피해 범위를 줄이는 시스템은, 모델이 절대 실수하지 않는 시스템보다 오래 버틸 가능성이 높습니다.