에이전트 메모리를 만들기 시작했을 때는 검색이 가장 어려운 문제일 거라고 생각했습니다. 어떤 database를 쓸지, 기록을 어떻게 embedding할지, 검색 결과를 어떤 순서로 보여줄지를 먼저 고민했습니다.
Luthn을 개발하면서 더 근본적인 질문이 먼저 나왔습니다. 이 메모리를 누가 볼 수 있어야 하는가입니다.
하나의 메모리가 Workspace 전체에 유용할 수는 있습니다. 그렇다고 관련된 모든 기록을 모든 사용자에게 공유해야 하는 것은 아닙니다. 그래서 검색을 튜닝하기 전에 이 경계부터 명시해야 했습니다.
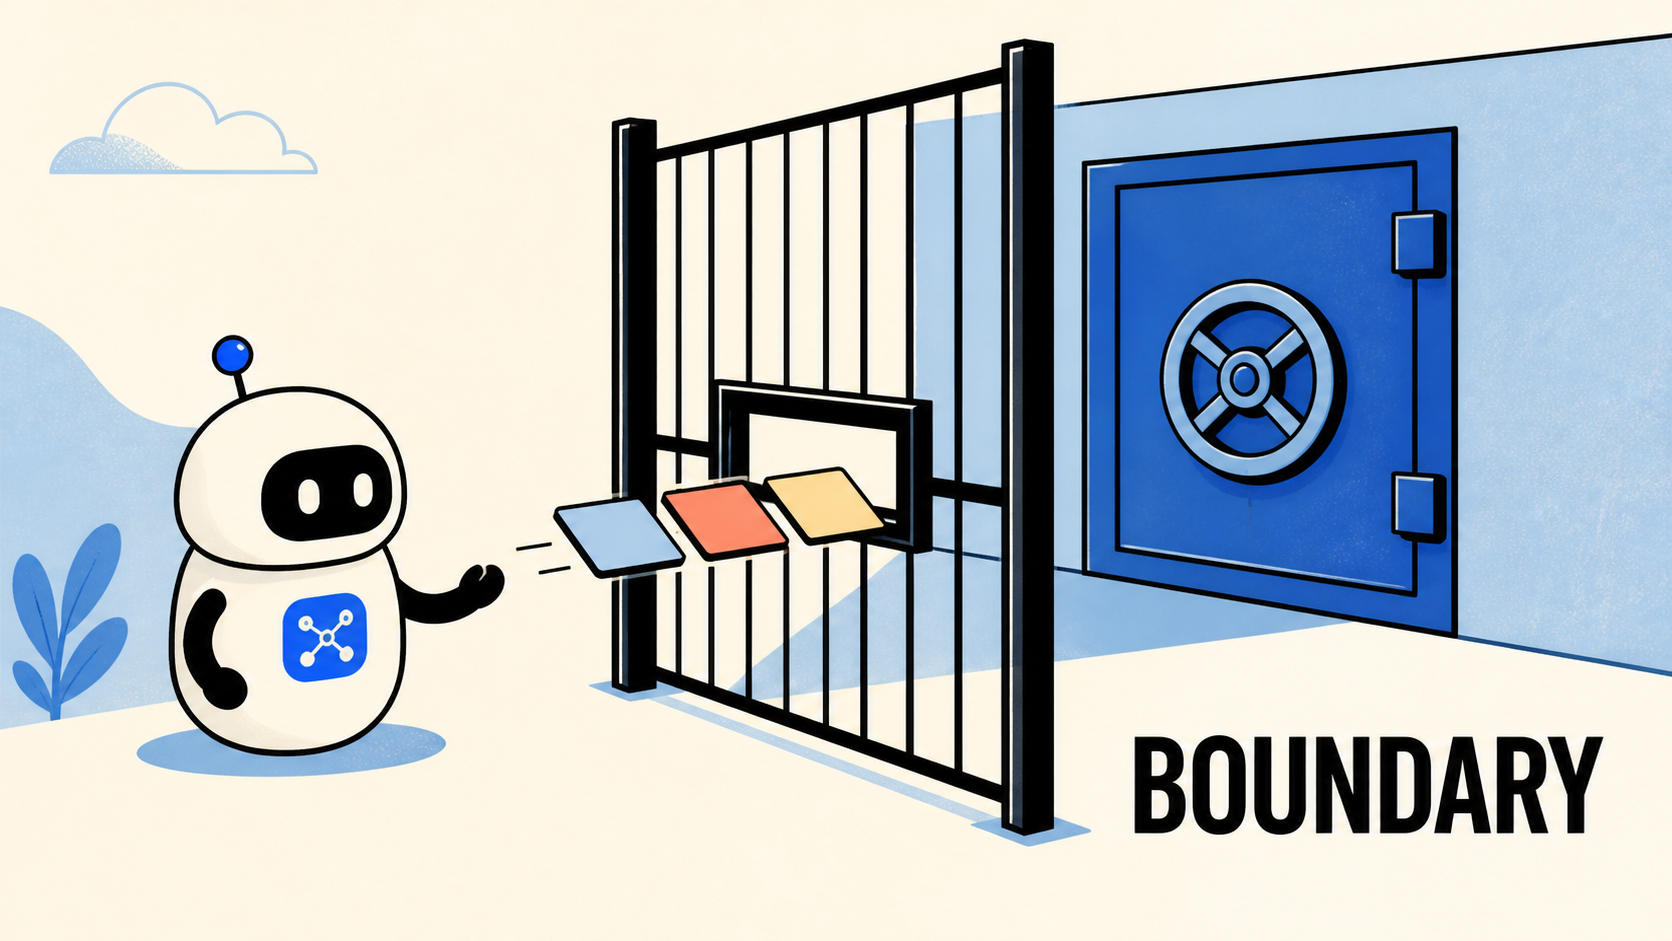
메모리 기록은 여러 경계를 통과합니다
Luthn은 원본 기록과 에이전트가 사용할 projection을 분리합니다. “저장하고 검색한다”가 아니라 다음에 가까운 흐름입니다.
| 경계 | 결정해야 할 것 | 에이전트에게 생기는 결과 |
|---|---|---|
| Intake | title·summary·content·tag를 포함한 전체 후보를 분류 | metadata에 숨은 민감 신호도 함께 검사 |
| Storage | private·restricted 자료를 저장 경계 안에 유지 | 저장됐다는 사실만으로 노출되지 않음 |
| Projection | 정책을 통과한 safe projection만 반환 | agent API가 제한 없는 원문을 내보내지 않음 |
| Ownership | 인증된 서버 상태에서 workspace·owner를 결정 | caller가 다른 범위를 선택할 수 없음 |
| Publication | 외부 발행을 별도 승인으로 처리 | 에이전트 visibility가 발행 권한이 되지 않음 |
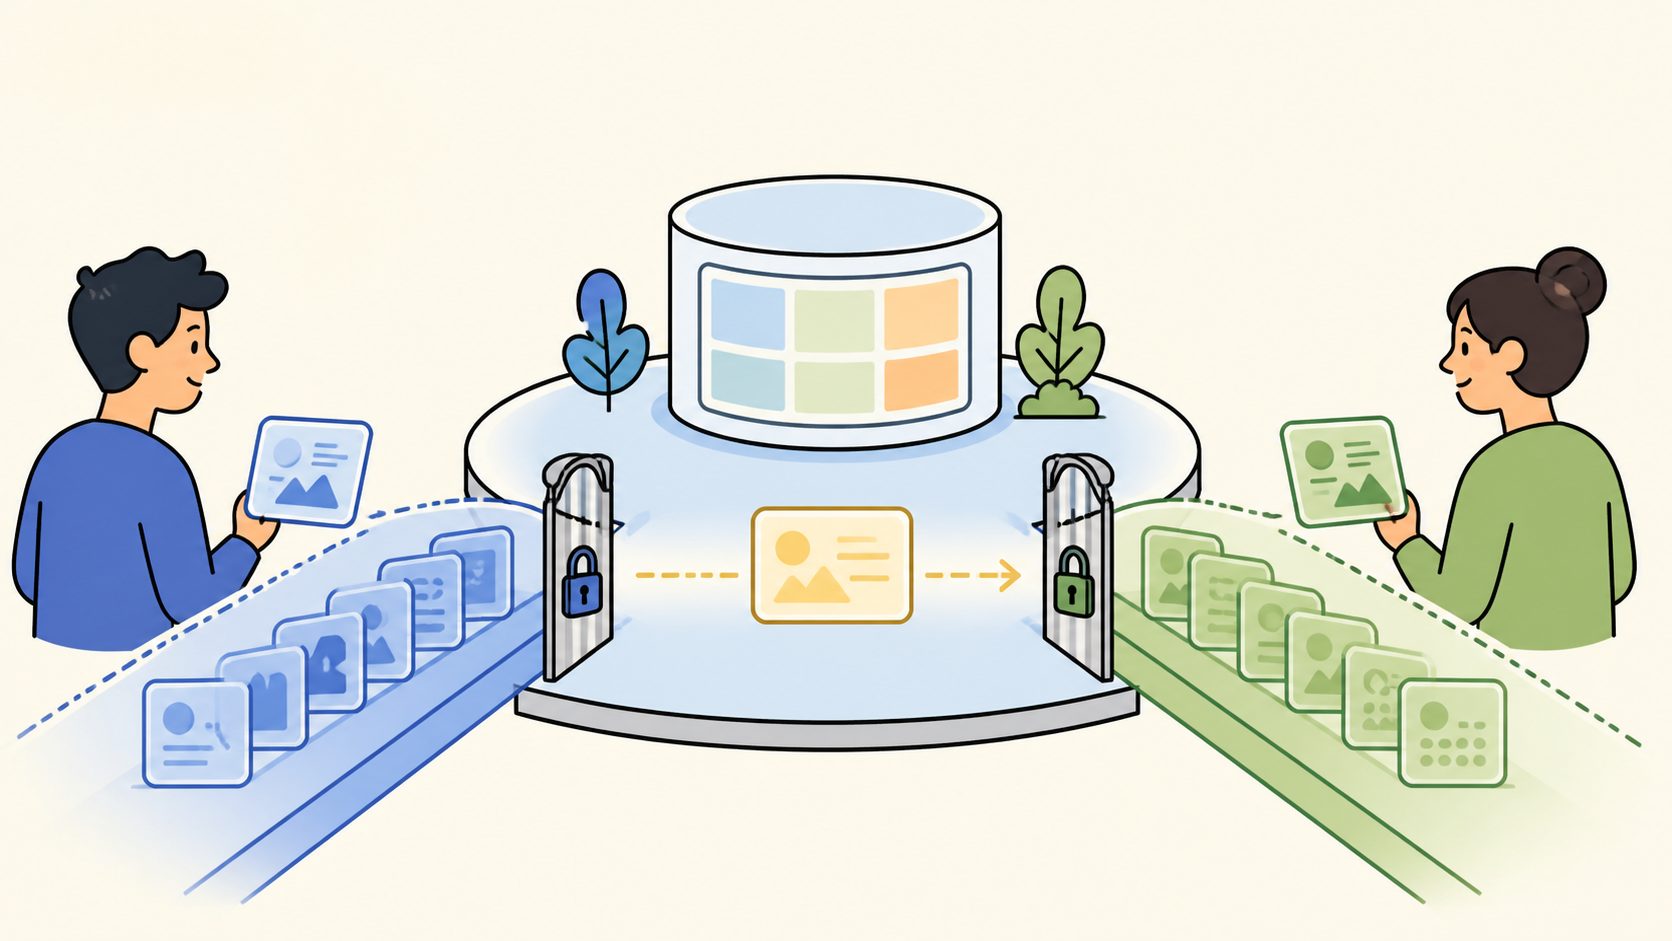
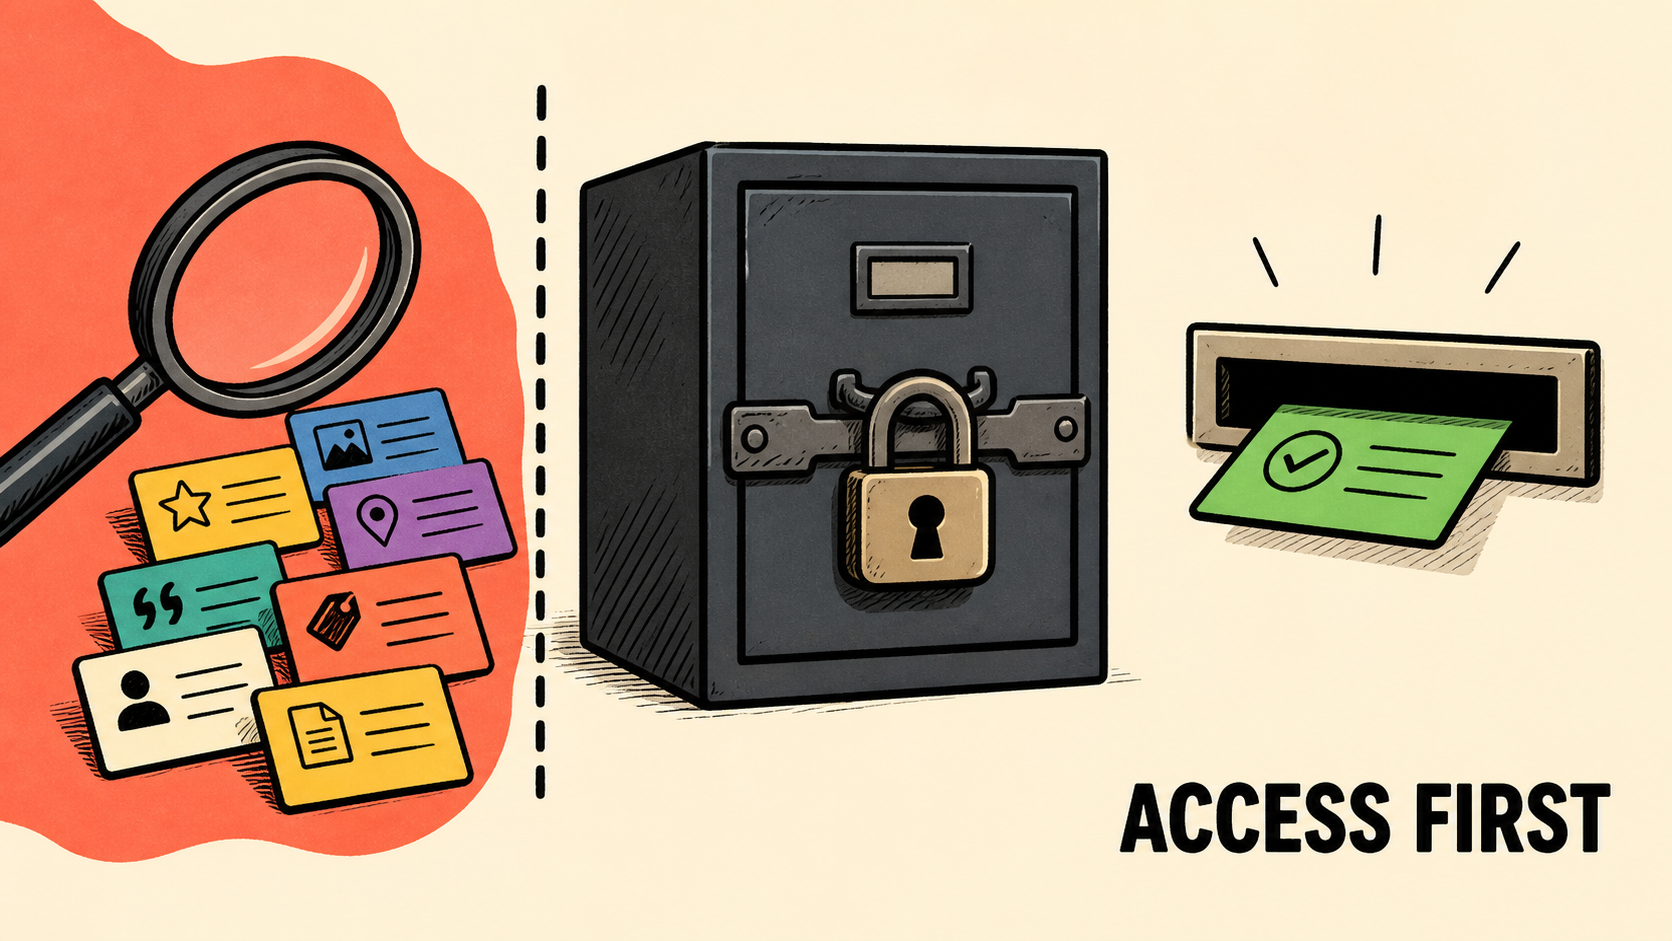
검색은 이미 자격을 얻은 projection의 순위를 정할 뿐, 기록을 보여줘도 되는지는 결정하지 않습니다.
이 구분 때문에 Luthn에서는 에이전트가 사용해도 안전한 지식, 수집 provenance, 민감 접근 요청, 원문을 서로 다른 것으로 다룹니다. 원문은 저장 경계 안에 남겨두고, 분류와 정책 검사를 통과한 뒤 제한된 safe projection만 에이전트에 전달합니다.
owner 격리는 서버가 결정해야 합니다
가장 위험한 지름길은 caller가 보낸 값을 신뢰하는 것입니다. JSON 안의 user ID, agent name, session label, provenance metadata가 권한 범위를 고르게 두는 방식입니다. Luthn의 API 문서는 workspace와 owner를 서버가 결정하는 authorization 상태로 다룹니다. 요청은 작업 맥락을 전달할 수 있지만, 그 요청을 승인할 경계를 스스로 선택할 수는 없습니다.
이 차이는 테스트에 드러납니다. 한 multi-user 테스트는 Alice의 memory를 만들면서 provenance에는 다른 user를 적습니다. Bob의 read는 NotFound가 되고, Bob의 search에는 결과가 나오지 않으며, 저장된 owner는 인증된 Alice로 남습니다. 같은 turn-summary idempotency key를 사용해도 개인 workspace 사이에서 충돌하지 않는지도 확인합니다.
Shared workspace는 예외 통로가 아닙니다. 같은 workspace 안에서는 두 agent가 public-safe memory를 읽을 수 있지만, provenance는 다른 agent의 범위 밖에 남습니다. 정책은 “private인가 public인가” 두 가지로 끝나지 않습니다. owner, workspace, visibility, sensitivity, retention, agent eligibility를 함께 판단해야 합니다.
보호 정보는 별도 경로로 다뤄야 합니다
Safe projection은 원문의 약한 복사본이 아닙니다. 처음부터 다른 output contract입니다. 사용자가 나중에 보호된 세부 정보를 꼭 요청하더라도, 일반 검색에 원문을 더하는 대신 요청자에게 묶인 access flow를 새로 만들어야 합니다.
승인 전에는 결과가 반환되지 않습니다. 승인 뒤에도 테스트는 응답이 no-store인지, 관계없는 agent가 handle을 사용해도 content를 얻지 못하는지, 요청 principal에게 허용된 내용과 읽기 횟수만 전달되는지를 확인합니다. classification 중 요청이 만료되면 이후에 승인할 수 없어야 합니다. public-safe redacted output이 없다면 승인만으로 raw content를 만들 수 없어야 합니다.
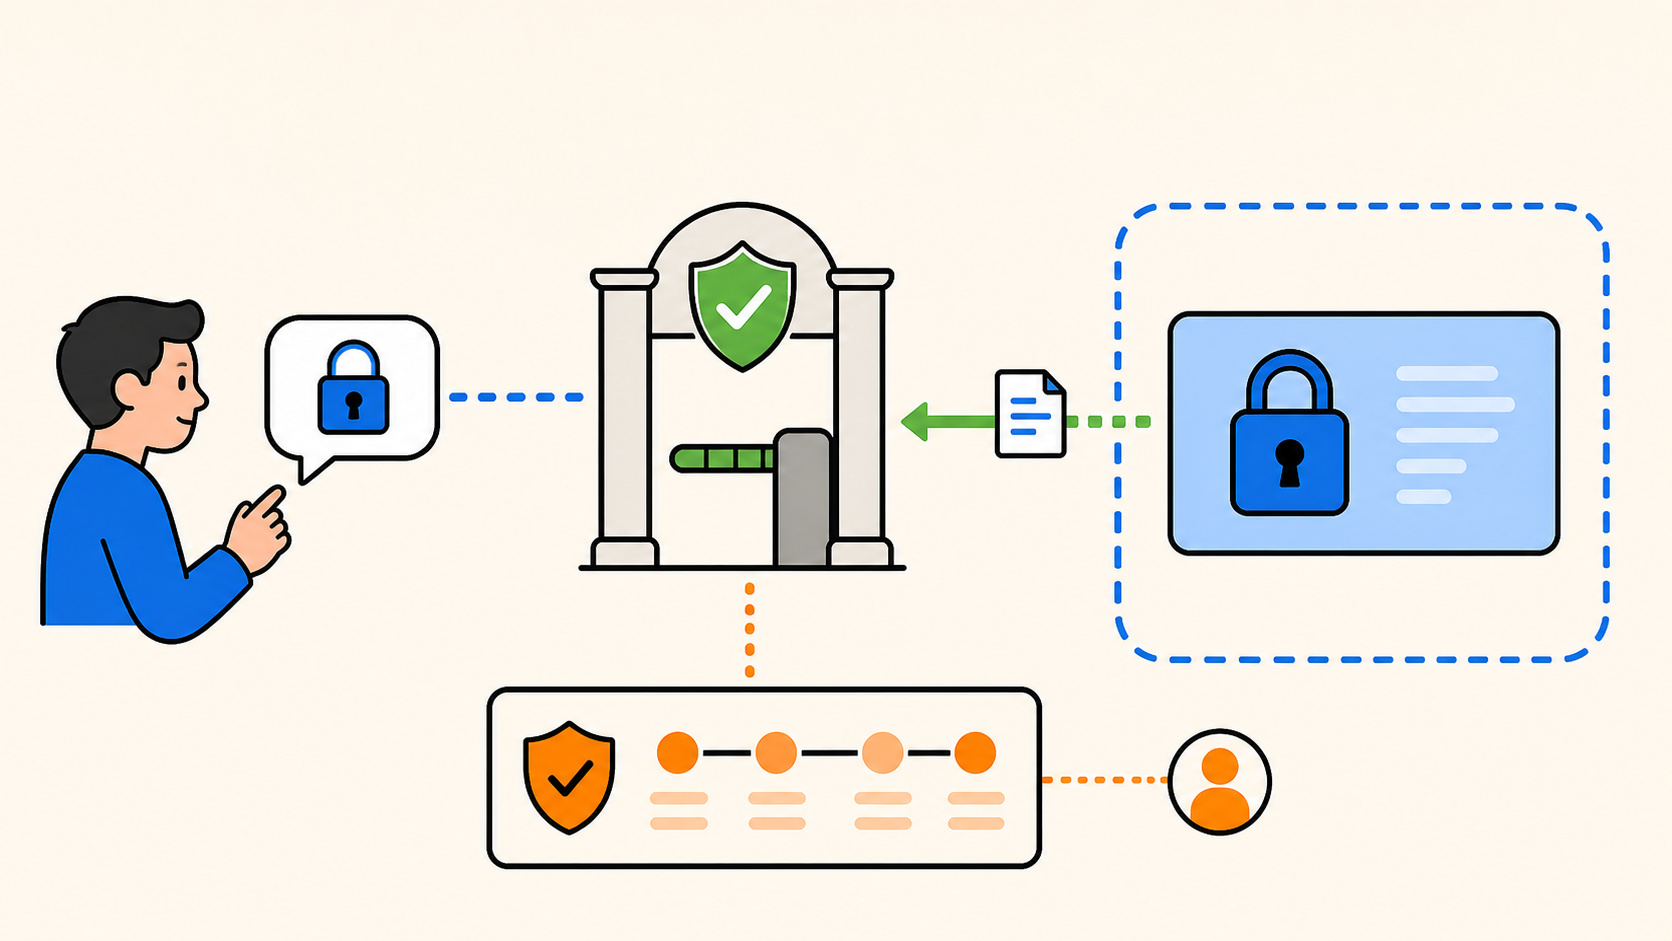
보호 결과는 짧은 시간 동안 요청자에게 묶이는 결정이지, 새로운 shared-memory item이 아닙니다.
여기서 audit 설계도 중요합니다. audit record에는 요청이 생성·승인·거절·만료·조회됐다는 사실을 남길 수 있습니다. 하지만 보호된 본문의 백업이 되어서는 안 됩니다. 기록은 결정을 설명해야 하지만 또 하나의 검색 표면이 되어서는 안 됩니다.
연구는 왜 이 순서가 필요한지 보여줍니다
이 문제는 이론에만 머물지 않습니다. 연구에서는 LLM agent memory에서 과거 사용자의 query를 추출하는 공격이 시연됐고, browser agent 조사에서는 일부 assistant가 웹페이지 전체를 전송하거나 금융·건강 관련 입력을 수집한 사례가 보고됐습니다. MCP 논의에서도 비슷한 구현 질문이 나옵니다. session ID나 transport 식별자가 곧바로 authorization 결정이 될 수 있는가 하는 문제입니다.
이 출처들이 Luthn의 구체적인 설계를 정해주는 것은 아닙니다. 다만 검색 품질을 첫 번째 acceptance criterion으로 삼으면 안 되는 이유는 설명해줍니다. 잘못된 owner에게 가장 관련성 높은 기록을 돌려주는 검색 시스템은 ranking은 개선했지만 더 중요한 계약은 깨뜨린 것입니다.
검색을 튜닝하기 전에 확인할 질문
embedding이나 ranking 변경을 비교하기 전에 다음 질문에 답할 수 있어야 합니다.
- 이 기록의 owner와 서버가 승인한 workspace는 누구의 것인가?
- 본문과 함께 어떤 field를 분류하는가?
- 어떤 projection만 agent context에 들어갈 수 있는가?
- visibility와 retention 규칙은 무엇인가?
- 다른 owner가 read와 search에서 기록이 사라졌다는 것을 확인할 수 있는가?
- 보호 요청이 만료·거절된 뒤에도 audit output이 content-free로 남는가?
Luthn이 memory 위험을 없앤 것은 아닙니다. 대신 위험이 어디에 있는지 더 쉽게 찾도록 만들었습니다. 먼저 classification과 policy, 다음 owner와 projection, 그 다음에 retrieval을 봅니다. 이것이 제가 남긴 핵심 순서입니다. 검색은 어떤 기록이 관련 있을지 알려주지만, 그 관련성이 visibility가 되어도 되는지는 권한 모델이 결정합니다.