한국 AI를 말할 때 더 이상 해외 모델을 얼마나 잘 가져다 쓰는지만 이야기할 필요는 없어 보입니다. 2026년 7~8월 국내 여러 팀이 충분히 큰 모델, 들여다볼 수 있는 오픈 웨이트 모델, 실제 제품에 넣기 쉬운 특화 모델을 잇달아 내놓았습니다. 정부의 독자 AI 파운데이션 모델 프로젝트 2단계도 네 팀에서 출발해 벤치마크·전문가·사용자 평가를 거쳐 세 팀을 남겼습니다.
의미 있는 진전입니다. 그렇다고 한국이 AI 강국이 됐다는 증명은 아닙니다. 더 어려운 질문은 따로 있습니다. 반도체 역량을 오래가는 소프트웨어와 제품 경쟁력으로 바꿀 수 있느냐는 문제입니다.
서로 다른 선택을 한 네 모델
LG AI Research는 7월 31일 K-EXAONE 2.0을 공개했습니다. 7,500억 개 파라미터 규모의 오픈 웨이트 모델이며 Apache 2.0 라이선스를 적용했습니다. LG가 공개한 수치는 24개 벤치마크 평균 70.1, OpenAI-MRCR 94.4, Ko-LongBench 89.6입니다. 범용 추론과 긴 문맥, 한국어 활용을 함께 겨냥한 모델로 읽을 수 있지만, 이 숫자들은 모델 제작사가 공개한 결과라는 점을 먼저 봐야 합니다.
SK텔레콤의 A.X K2는 다른 길을 택했습니다. 공식 저장소에 따르면 6,880억 개 파라미터의 혼합 전문가 모델이며 활성 파라미터는 330억 개입니다. SKT는 AIME26 97.1, KMMLU-Pro 80.5, CLIcK 91.6, Telecom τ²-Bench 98.0을 공개했습니다. 추론 모델인 동시에 한국어와 산업 현장을 겨냥한 도구라는 메시지가 수치 구성에 드러납니다.
업스테이지의 Solar Open 2도 오픈 웨이트 전략입니다. 전체 2,500억 개, 활성 150억 개 파라미터로 소개됐고 LiveCodeBench 92.4, MMLU-Pro 86.2, 한국어 평균 85.4, Ko-GDPval 86.75라는 결과를 제시했습니다. 여기서 중요한 것은 단순한 크기가 아닙니다. 희소 모델은 메모리 사용량과 서빙 비용, 소프트웨어 스택을 잘 다룰 수 있다면 실제 배포의 선택지가 될 수 있습니다.
Motif Technologies의 Motif 3가 들어오면서 비교의 축도 넓어졌습니다. 공식 모델 카드와 기술 보고서는 3,140억 개 전체 파라미터 중 토큰당 약 132억 개를 활성화하는 MoE 모델, 256K 컨텍스트, 약 12.5조 토큰 학습을 제시합니다. 한국어와 추론·법률·금융 데이터에 무게를 둔 오픈 웨이트 모델이며, Artificial Analysis 모델 페이지에서는 AAII v4.1.1 점수 47로 표시됩니다. 국내 모델 중 가장 높은 숫자라는 점보다, 대형 모델의 용량과 비교적 작은 활성 계산량을 함께 가져가려는 설계가 더 흥미롭습니다.
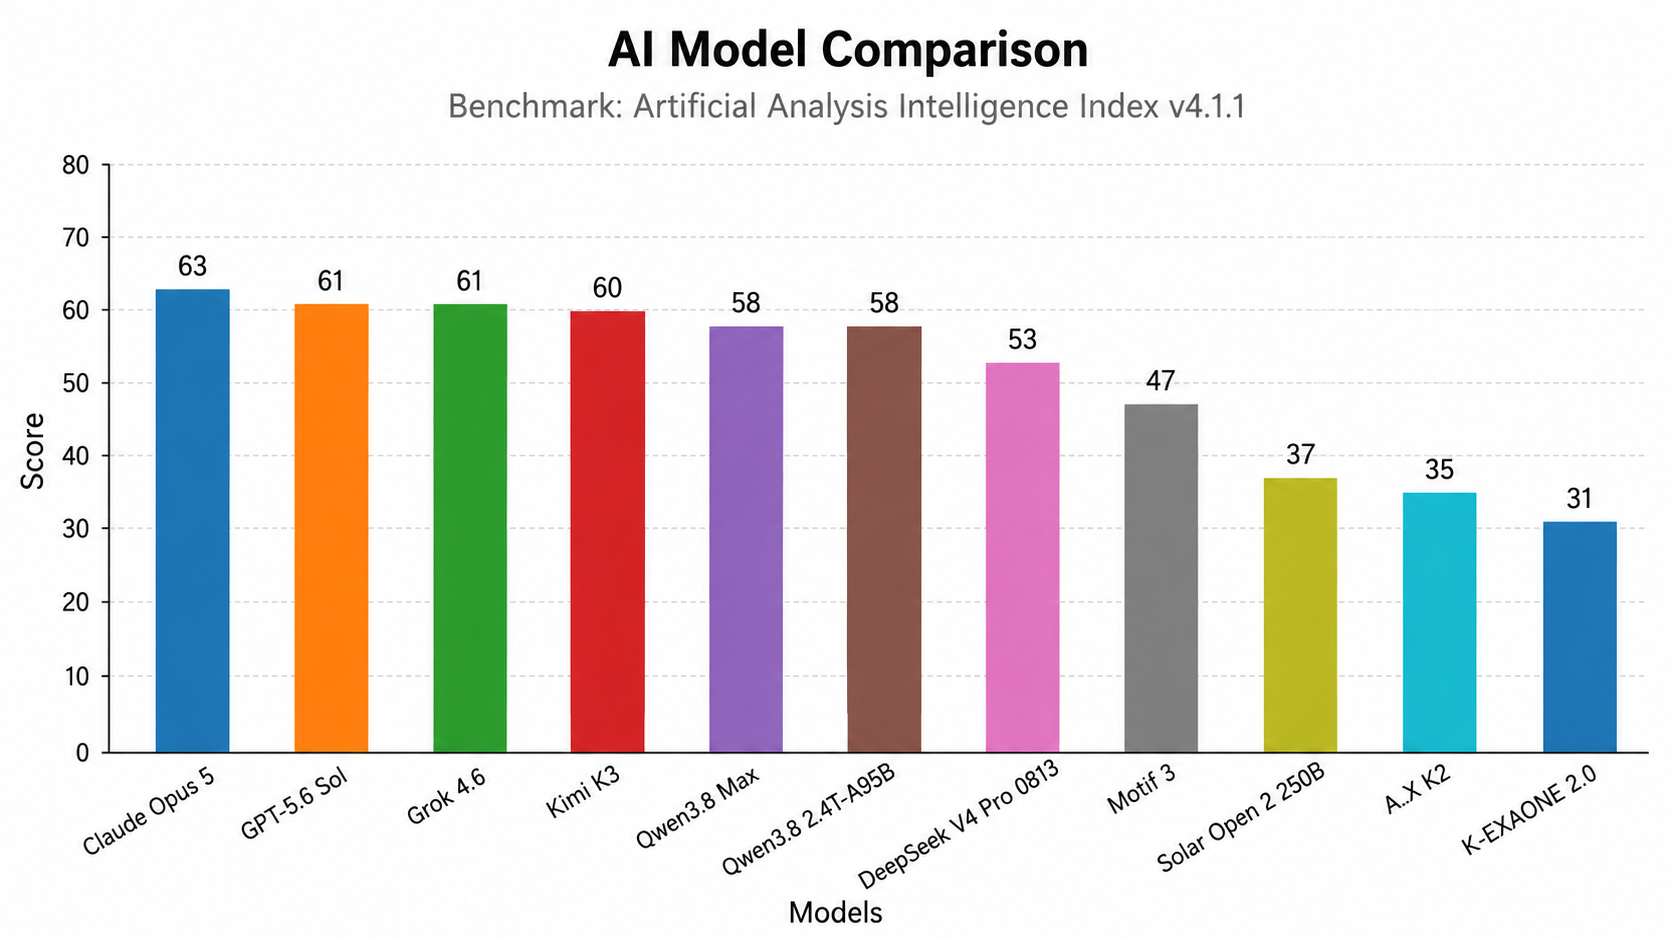
첨부 비교 차트에 표시된 특정 시점의 스냅샷입니다. Artificial Analysis의 모델 점수와 순위는 평가 버전과 시점에 따라 달라질 수 있습니다.
| 모델 | 공개된 구성 | 첨부 차트의 AAII 점수 | 함께 볼 공개 수치 |
|---|---|---|---|
| Motif 3 | 3,140억 개 / 활성 132억 개 | 47 | 256K 컨텍스트, 12.5T 학습 토큰 |
| Solar Open 2 | 2,500억 개 / 활성 150억 개 | 37 | LiveCodeBench 92.4, 한국어 평균 85.4 |
| A.X K2 | 6,880억 개 / 활성 330억 개 | 35 | AIME26 97.1, Telecom τ²-Bench 98.0 |
| K-EXAONE 2.0 | 7,500억 개 | 31 | 24개 평균 70.1, Ko-LongBench 89.6 |
이 표를 하나의 절대 순위표로 읽으면 안 됩니다. 앞의 네 점수는 같은 AAII 버전의 종합 지표라는 장점이 있지만, Artificial Analysis도 이 지표가 모든 사용 사례에 그대로 적용되지는 않는다고 설명합니다. 게다가 AAII v4.1.1은 영어 중심의 텍스트 평가이며 한국어·이미지·음성 능력은 별도 평가로 다뤄집니다.
AAII 점수는 무엇을 합친 값인가
Artificial Analysis Intelligence Index v4.1.1은 9개 평가를 네 범주로 묶어 가중 평균합니다. 에이전트가 34%로 가장 크고, 코딩 24%, 과학적 추론 24%, 일반 능력 18%입니다. 그래서 AAII 점수는 단순한 지식 퀴즈 점수가 아니라 도구를 쓰고, 코드를 실행하고, 긴 문서를 읽고, 모르는 것을 모른다고 말하는 능력까지 섞은 지표입니다.
| 벤치마크 | 간단한 의미 |
|---|---|
| GDPval-AA v2 | 파일 결과물을 만들어내는 실제 지식노동·직무 과제 |
| τ³-Banking | 문서를 검색하고 여러 도구로 금융 계정 작업을 처리하는 에이전트 과제 |
| Terminal-Bench v2.1 | 터미널에서 소프트웨어·시스템·데이터·보안 작업을 끝내는 능력 |
| SciCode | 과학 계산 문제를 Python 코드로 풀고 테스트를 통과하는 능력 |
| AA-LCR | 약 10만 토큰의 여러 긴 문서를 읽고 추론하는 능력 |
| AA-Omniscience | 사실을 맞히고 모르는 내용은 추측하지 않는지, 즉 환각을 얼마나 줄이는지 |
| Humanity’s Last Exam | 수학·인문학·자연과학의 어려운 학술 문제를 푸는 능력 |
| GPQA Diamond | 생물·물리·화학 분야의 대학원 수준 ‘검색으로 바로 답하기 어려운’ 문제 |
| CritPt | 공개되지 않은 연구 수준 물리 문제를 수식·숫자·Python으로 푸는 능력 |
이 설명을 붙여야 차트의 47, 37, 35, 31을 제대로 읽을 수 있습니다. Motif 3가 47점을 얻었다는 사실은 여러 평가에서 강점을 보였다는 뜻이지, 한국어 상담이나 특정 제조 현장의 정확도가 자동으로 47점이라는 뜻은 아닙니다. 반대로 K-EXAONE의 한국어·긴 문맥 강점이나 A.X K2의 통신·산업 과제 수치는 AAII 하나로 모두 설명되지 않습니다. 모델 선택은 종합 점수와 실제 업무 평가를 함께 봐야 합니다.
반도체 기반은 강점이지만 자동 승리는 아니다
한국은 반도체 덕분에 좋은 출발점에 서 있습니다. 메모리와 HBM, 패키징, 제조 장비, 대형 산업 고객과의 관계는 모델 연구에서 하드웨어를 고려한 서비스까지의 거리를 줄일 수 있습니다. “모델을 만들 수 있는가”에서 끝나지 않고 “공장과 엣지, 기업 데이터 옆에서 어떤 모델을 돌릴 것인가”를 묻기 좋은 조건입니다.
A.X K2 발표는 제조·국방·바이오를 활용 분야로 제시합니다. 이는 회사가 밝힌 방향이지, 해당 업종이 이미 모델을 도입했다는 증거는 아닙니다. 그래도 방향은 합리적입니다. 한국의 승부처는 모든 범용 챗봇 비교에서 이기는 데 있지 않을 수 있습니다. 한국어 문서를 잘 이해하고, 기존 산업 업무와 연결되며, 국내 데이터와 비용 제약 안에서 작동하는 모델을 만드는 데 있을 수 있습니다.
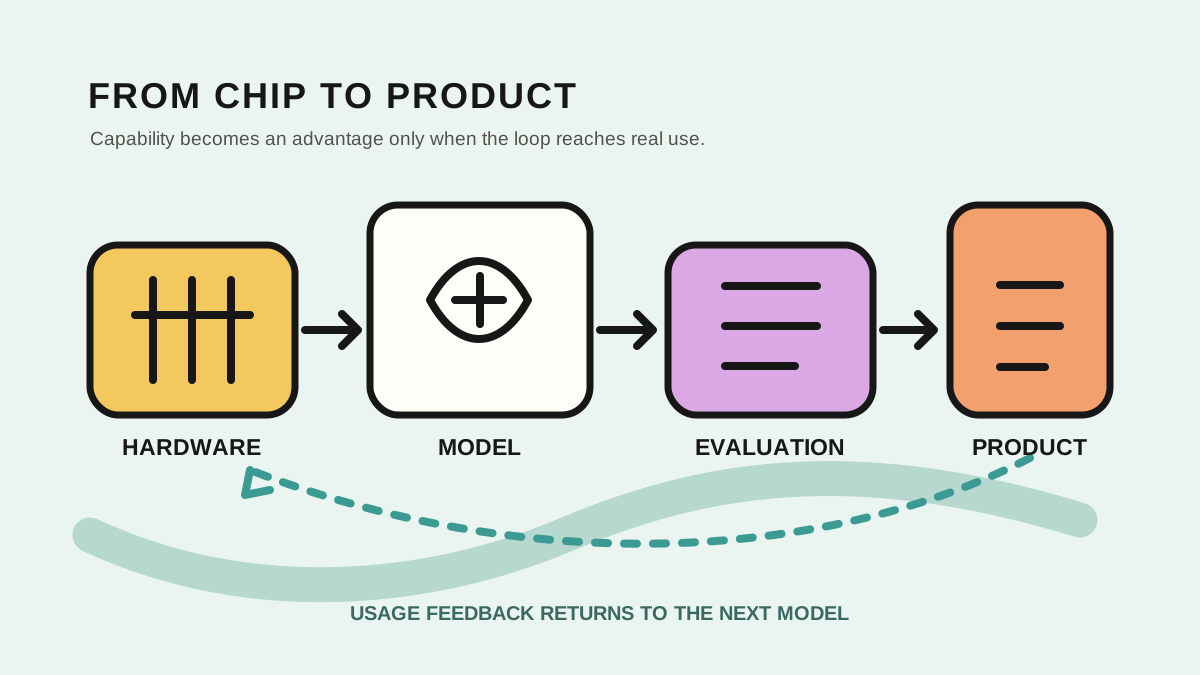
하드웨어가 AI 경쟁력이 되려면 사용 피드백이 다음 모델과 제품 결정으로 돌아와야 합니다.
실패 위험은 발표회에서 멈추는 것입니다. 높은 벤치마크 점수가 안정적인 API, 좋은 문서, 양자화 체크포인트, 감당할 만한 추론 가격, 재현 가능한 평가, 모델 위에 만들고 싶은 개발자를 자동으로 만들어주지는 않습니다. 이 층위가 따라오지 않으면 한국은 쓸 만한 모델을 보유하고도 제품 시장에서는 제3자의 관망자로 남을 수 있습니다.
제 생각은 조건부 낙관이다
저는 한국이 더 이상 제3자의 관망자로 남을 이유는 줄었다고 봅니다. 컴퓨팅과 메모리 공급망, 실제 운영 데이터를 가진 대기업, 대학과 모델 팀, 국가 규모 실험을 지원할 공공 프로그램이 함께 있습니다. 최근 공개된 모델들은 적어도 모델 층위가 비어 있지 않다는 사실을 보여줍니다.
하지만 실패 시나리오도 선명합니다. 앞으로 1년을 파라미터 수와 몇 개의 최고 벤치마크, 출시 행사만으로 평가하면 강점은 빠르게 희미해질 수 있습니다. 더 결정적인 증거는 덜 화려한 곳에 있습니다. 몇 팀이 실제 제품을 출시하는지, 파일럿 뒤에도 고객이 계속 쓰는지, 개발자가 폐쇄형 API에서 얼마나 쉽게 옮겨오는지, 사용 데이터가 신뢰를 깨지 않고 다음 버전을 개선하는지 봐야 합니다.
그래서 저는 한국을 아직 AI 승자라고 부르지 않겠습니다. 그렇다고 실패자라고 부를 단계도 아닙니다. 반도체 강점이 제품을 만드는 습관을 배워야 하는 지점에 도착했다고 생각합니다. 벤치마크 차트는 신호입니다. 진짜 결과는 차트 다음의 피드백 루프에서 나옵니다. 어떤 모델이 쓰이고, 비용이 지불되고, 실수가 측정되고, 더 나은 시스템이 다시 출시되는가가 한국 AI의 성적표가 될 것입니다.