에이전트에 기억을 붙이면 당연히 더 좋아질 것처럼 보입니다. 코딩 에이전트가 같은 버그를 전에 본 적이 있다면 다시 실수할 이유가 없고, 저장소에 정해진 작업 방식이 있다면 매 세션마다 설명할 필요도 없어 보입니다.
최근 연구는 조금 다른 답을 줍니다. 기억은 에이전트를 개선할 수 있지만, 에이전트가 어떤 방식으로 탐색하는지와 기억을 어디까지 적용하는지에 따라 결과가 달라집니다. 중요한 질문은 에이전트가 얼마나 많이 기억하느냐가 아닙니다. 다음 판단에 어떤 기억이 영향을 줘야 하고, 어떤 기억은 빠져 있어야 하는지입니다.
기억은 도움도 되지만 탐색을 좁힐 수 있습니다
ACL 2026 Findings 논문은 머신러닝 엔지니어링 에이전트에 동적 코딩 기억을 붙이고 두 가지 작업 방식을 비교합니다. 하나는 디버깅과 개선을 반복하는 순차형 에이전트이고, 다른 하나는 여러 해결책을 병렬로 시도하는 tree-search 에이전트입니다.
결과는 기억의 단순한 승리가 아니었습니다. 순차형 작업에서는 기억이 반복되는 실수를 줄이고, 앞선 시도와 다음 수정을 연결하는 데 도움이 됐습니다. 반면 탐색형 작업에서는 같은 안정성이 제약으로 바뀔 수 있습니다. 과거 절차가 탐색의 다양성을 줄이고, 에이전트를 익숙한 답 쪽으로 너무 빨리 밀 수 있기 때문입니다.
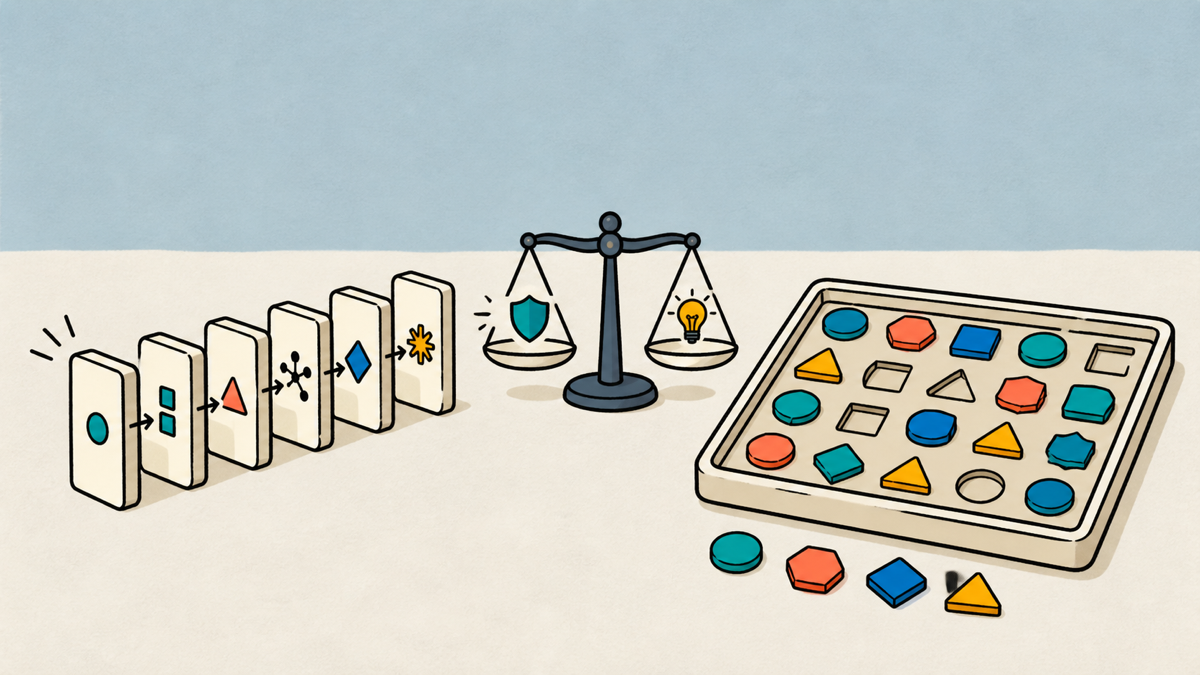
반복 수리에 유용한 기억이 열린 탐색에도 자동으로 유용한 것은 아닙니다.
이 차이는 실무에서 선명합니다. 특정 테스트 실패를 고친 방법은 같은 컴포넌트가 다시 깨졌을 때 큰 도움이 됩니다. 하지만 새로운 아키텍처를 조사할 때 과거의 수정법을 기본 정답처럼 취급하면 다른 해법을 찾기 어려워집니다. 반복 오류를 줄이는 일과 새 해법을 발견하는 일은 같은 목표가 아닙니다. 반복 실수만 줄이도록 만든 memory layer가 어느 순간 탐색 자체를 조용히 막을 수 있습니다.
컨텍스트 파일에도 비용이 붙습니다
저장소 수준의 지침에서도 비슷한 긴장이 나타납니다. ETH 취리히와 SRI 연구진은 ICLR 2026 워크숍에서 여러 코딩 에이전트와 언어 모델을 대상으로 AGENTS.md 형식의 컨텍스트 파일을 평가했습니다. 연구가 실험한 조건에서는 컨텍스트 파일이 작업 성공률을 높이지 못한 반면, 추론 비용은 20% 이상 늘었습니다.
연구는 에이전트가 지침을 대체로 잘 따른다는 점도 관찰했습니다. 그래서 불필요한 지침이 더 문제가 됩니다. 현재 작업과 관계없는 요구사항까지 지키느라 파일을 더 읽고, 테스트를 더 실행하고, 추가 조건을 맞추는 데 token과 시간이 들 수 있습니다. 지킨다는 사실이 유용하다는 뜻은 아닙니다.
이 결과가 AGENTS.md가 쓸모없다거나 모든 컨텍스트 파일을 없애야 한다는 뜻은 아닙니다. 더 좁은 교훈은 실용적입니다. 사람이 작성하는 컨텍스트에는 안정적인 요구사항을 남기고, 현재 판단을 바꾸지 않는 과거 선호·추정·반복 주의사항은 덜어내야 합니다.
제한된 기본값은 trade-off에 대한 한 가지 답입니다
이 긴장을 실제 설계에 반영한 사례가 Luthn입니다. Luthn의 기본 auto-recall은 매 턴마다 private store 전체를 검색하지 않습니다. 새 작업이나 material topic이 시작될 때 최대 3개 항목, 약 600토큰의 budget, 200밀리초 fail-open 제한으로 작은 context pack을 요청하고 10분 동안 재사용합니다.
이 숫자가 모든 memory system에 적용할 정답은 아닙니다. 프로젝트의 전체 history를 매번 들고 오지 않으면서도 작업 시작점에는 도움이 되도록 의도적으로 작은 기본값을 둔 것입니다. project·task·topic key도 제한된 범위에서만 recall을 좁히며, 항목이 agent-visible이 되기 전 classification과 safe-projection 규칙을 거칩니다.
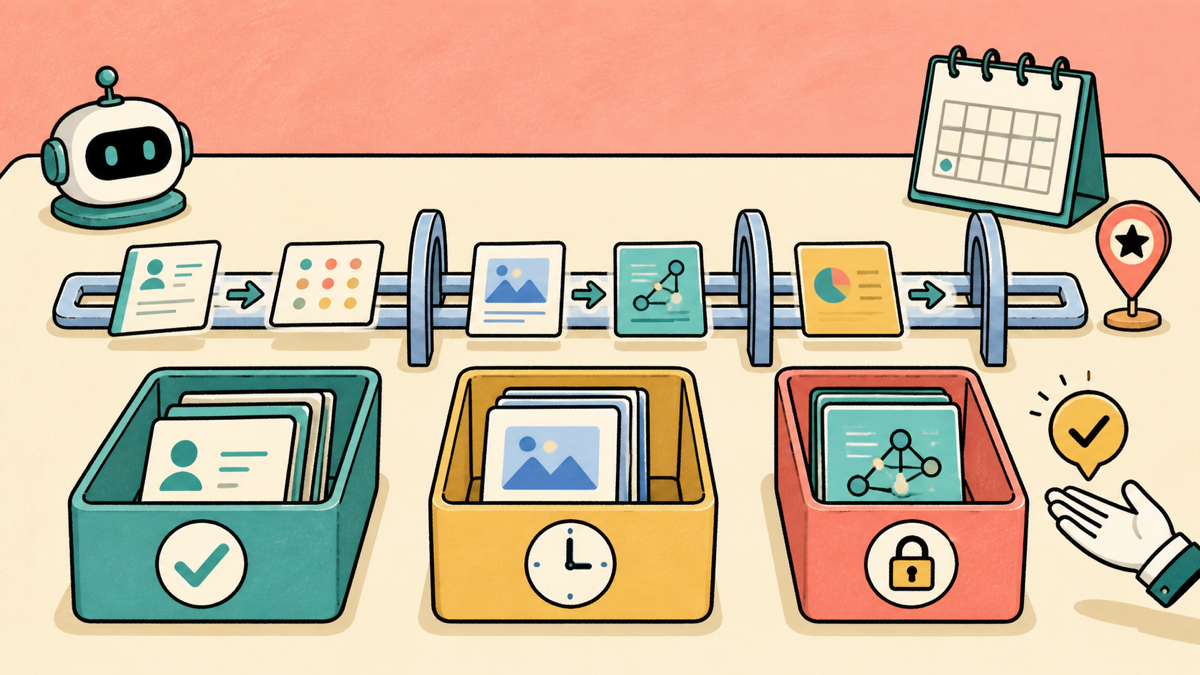
유효성·만료·접근 권한이 눈에 보이는 결정이 되면 기억을 운영하기 쉬워집니다.
제한된 context pack은 실패 방식도 바꿉니다. 조회 결과가 없거나 service가 unavailable이면 확인되지 않은 기억으로 빈칸을 채우지 않습니다. 검증되지 않은 맥락 없이 계속 진행하거나, 필요한 맥락을 확인하지 못했다고 말합니다. 무제한 recall보다 덜 편리하지만 오래된 기록을 보이지 않는 전제로 바꾸는 것보다는 안전합니다.
기억에는 종류와 경계가 필요합니다
실용적인 memory system이라면 최소한 네 종류의 정보를 나눠야 합니다. 절차 기억은 과거에 효과가 있었던 방법입니다. 프로젝트 상태는 특정 시점의 저장소나 작업에 대한 사실입니다. 선호는 사용자나 팀이 일하는 방식입니다. 근거와 가설은 확인된 내용, 불확실한 내용, 아직 검증하지 않은 판단을 구분합니다.
이 범주들을 같은 검색 규칙으로 다루면 안 됩니다. 검증된 build command는 자동으로 재사용해도 괜찮을 수 있습니다. 임시 프로젝트 결정에는 만료 시점이 필요합니다. 사용자 선호는 특정 owner나 workspace에만 적용될 수 있습니다. 추론은 자주 검색됐다는 이유만으로 사실로 승격하면 안 됩니다.
metadata는 기억을 꾸미는 부속 정보가 아니라 기억의 일부입니다. 기록의 출처와 마지막 확인 시점, 적용되는 project·task 범위, 민감도, 만료·충돌 시 처리 방식이 남아야 합니다. 검색된 기억이 실제 답변이나 tool action에 영향을 주었는지도 확인할 수 있어야 합니다.
이 글에서 확인한 것과 아직 하지 않은 것
위 연구에 관한 주장은 인용한 연구에서 가져왔고, Luthn의 제한값은 공개 문서에서 확인했습니다. 아직 특정 memory configuration이 항상 최선이라고 증명하는 통제된 local A/B 실험을 했다는 뜻은 아닙니다. 그 실험을 하려면 task·model·budget을 고정한 뒤 memory layer만 바꿔야 합니다.
| 비교 | 기록할 결과 |
|---|---|
| memory 없음과 제한된 memory | 성공 여부·반복 오류·수정 횟수 |
| 작은 pack과 큰 pack | token 사용량·지연 시간·무관한 context |
| memory 사용과 withheld | 탐색 다양성·첫 viable solution까지 걸린 시간 |
| 최신 기록과 오래된 기록 | 오래된 조언을 알아차리고 복구하는지 |
| 충돌하는 기록 | 충돌을 보여주는지 조용히 덮는지 |
핵심은 memory가 더 많이 검색했는지를 칭찬하는 것이 아니라 무엇을 바꿨는지 측정하는 데 있습니다. 장기기억은 단순한 저장 기능이 아니라 에이전트의 제한된 context와 주의를 배분하는 정책입니다. 좋은 기억은 어렵게 얻은 지식을 다음 작업으로 가져오고, 좋은 경계는 그 지식이 모든 새 문제의 보이지 않는 전제가 되는 것을 막습니다.
에이전트 메모리의 다음 단계는 모든 것을 기억하는 일이 아닙니다. 언제 기억하지 않을지, 언제 검색하지 않을지, 언제 확인을 요청할지를 아는 일입니다.