2026년 8월 10일, Meta AI Research가 Muse Glimmer를 공개했습니다. 300억 파라미터 규모의 오픈 웨이트 모델이며, Meta는 소비자용 GPU 한 장을 탑재한 Mac이나 PC에서 로컬 에이전트 작업을 수행하도록 설계했다고 설명합니다. 중요한 점은 모델 크기만이 아닙니다. 로컬에서 상시 실행되는 에이전트를 제품의 목표로 삼았다는 점입니다.
Meta가 실제로 공개한 것
Meta에 따르면 Muse Glimmer는 상시 실행되는 로컬 에이전트, 함수 호출, 로컬 코딩, LLM-as-a-judge 평가를 겨냥합니다. 가중치는 Apache 2.0 라이선스로 Hugging Face에 공개됐고 개발자 문서도 함께 제공됩니다. 같은 크기 범주의 주요 모델과 비교한 성능도 제시했습니다. 다만 이 마지막 내용은 Meta가 보고한 벤치마크 결과이며, 독립 기관의 평가와는 구분해서 읽어야 합니다.
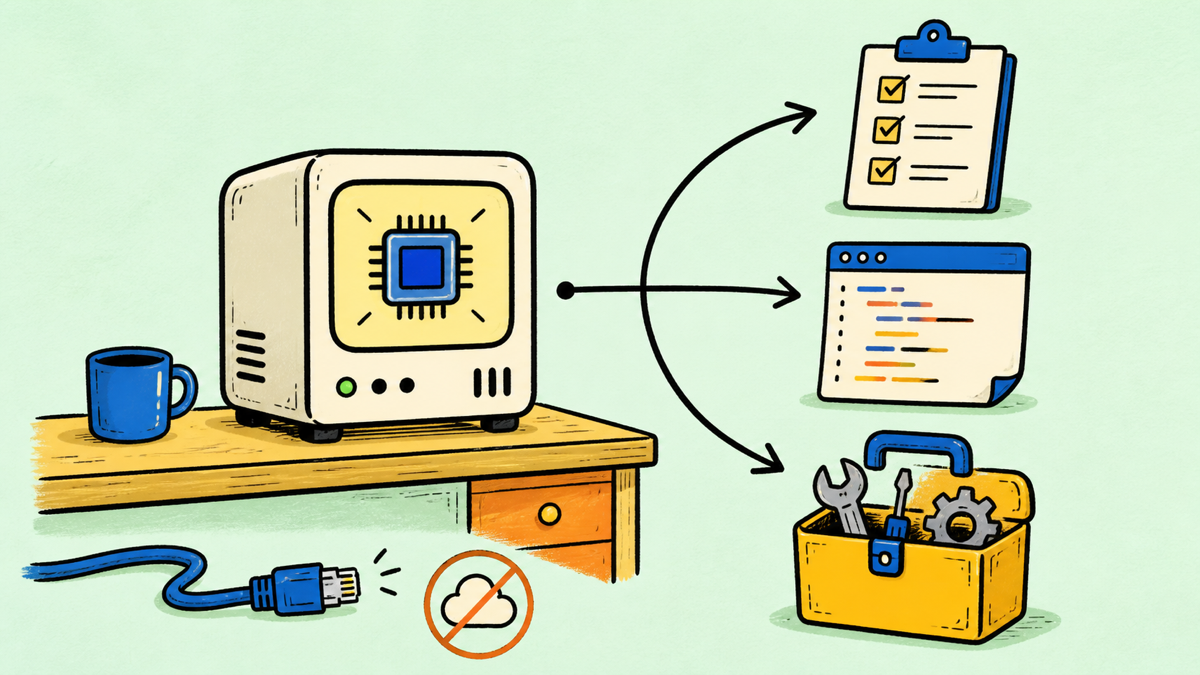
로컬 에이전트의 핵심은 추론만이 아닙니다. 모델의 판단 이후 컴퓨터가 어떤 일을 수행하는지가 함께 중요합니다.
공식 발표의 여러 약속을 한 문장으로 뭉뚱그리면 안 됩니다.
| 발표 내용 | 독자가 읽어야 할 의미 |
|---|---|
| 오픈 웨이트 | 명시된 라이선스 아래 공개된 가중치를 직접 확인하고 실행할 수 있습니다. |
| 로컬 에이전트 중심 | 도구 사용·긴 작업·로컬 코딩이 학습과 평가의 목표에 포함됩니다. |
| 소비자용 GPU 한 장 | “로컬에서 돌아간다”보다 구체적이지만 실제 속도는 하드웨어와 양자화에 달립니다. |
| 강한 벤치마크 결과 | 실험 대상을 고르는 참고이지, 개인 작업의 성공을 보장하는 결과는 아닙니다. |
소비자용 GPU 한 장이 실제로 뜻하는 것
Meta는 300억 파라미터 모델을 full precision으로 실행하면 55GB가 넘는 메모리가 필요하다고 설명합니다. 약 4비트 양자화 버전은 모델을 20GB 아래로 줄이고, 회사는 17GB K-Quant 구성과 drafter를 24GB·32GB 장비에서 시험했다고 밝혔습니다. 로컬 실행 목표가 더 구체적으로 보이는 수치지만, 여전히 제공자가 측정한 결과입니다. 실제 장비에서는 메모리 여유·지연시간·발열·도구 호출 동작을 다시 확인해야 합니다.
장점은 분명합니다. 로컬 모델은 사내망이나 인터넷이 끊긴 상황에서도 모든 프롬프트를 호스팅 API로 보내지 않고 작업할 수 있습니다. 짧은 도구 작업에서는 네트워크 왕복을 줄일 가능성도 있습니다. 다만 이것은 배포 설계의 특성이지 모델만 설치하면 자동으로 얻는 개인정보 보호 보장은 아닙니다.
로컬이라고 자동으로 비공개가 되지는 않습니다
로컬 모델도 클라우드 도구를 호출하고, 파일을 업로드하고, 보호되지 않은 기억 저장소에 민감한 내용을 기록할 수 있습니다. 실제 데이터가 어디로 이동하는지는 에이전트 런타임, 도구 권한, 로그, 백업, 업데이트 경로가 결정합니다. 개인 장비에서 실행하면 하나의 서비스 경계는 줄어들지만, 프롬프트 인젝션·위험한 도구 사용·자격증명 유출·잘못된 반복 실행이 사라지는 것은 아닙니다.
그래서 Muse Glimmer는 완성된 로컬 비서라기보다 로컬 에이전트 스택을 구성하는 부품에 가깝습니다. 도입 전에는 선택한 양자화에서 메모리 사용량, 반복 도구 호출의 지연시간, 도구 오류 이후의 복구, 로컬과 네트워크 작업의 경계를 따로 측정해야 합니다. 답변이 자연스러운지만 보지 말고 에이전트가 무엇을 기억하고 바꿨는지도 기록해야 합니다.
Muse Glimmer의 의미는 모든 에이전트가 데스크톱 GPU로 이동한다는 데 있지 않습니다. 주요 모델 제공자가 로컬에서 상시 실행되는 에이전트를 일급 목표로 제시하고, 다른 개발자가 그 위에 시스템을 만들 수 있도록 가중치를 공개했다는 점입니다. 다음 경쟁은 모델 품질만으로 끝나지 않을 것입니다. 로컬 에이전트가 무엇을 사용했고 무엇을 바꿨으며 어떤 정보가 장비 밖으로 나가지 않았는지도 기준이 됩니다.