AI를 호출하는 일은 쉽습니다. 실제 작업에 맞게 쓰는 일은 더 어렵습니다.
새 모델과 서비스는 계속 등장하고, 어제 어려웠던 일이 오늘은 몇 줄의 대화만으로 가능해집니다. 하지만 기능이 많아질수록 선택도 늘어납니다. 어떤 모델이 작업을 봐야 하는지, 어떤 맥락을 줘야 하는지, 무엇을 바꿀 수 있는지, 결과를 안심하고 이어서 써도 되는지를 함께 판단해야 합니다.
이 글은 그런 질문을 탐색하기 위한 출발점입니다. AI를 마법 버튼처럼 보여주기보다 사람이 하던 일을 계속 이어갈 수 있도록 돕는 작은 도구를 만들고 싶습니다. 가장 인상적인 답변보다 중요한 것은 다음 단계의 작업을 사람이 검토하고 실행하기 쉬워지는 것입니다.
진짜 문제는 작업에 맞추는 일입니다
성능 좋은 모델도 불편할 수 있습니다. 매번 같은 배경을 반복해서 설명해야 하거나, 긴 답변에서 쓸 내용을 다시 골라야 하거나, 편리한 연결 하나 때문에 에이전트가 너무 많은 권한을 갖게 될 수 있습니다. 편리함은 화면의 문제가 아니라 맥락·권한·피드백·복구를 함께 설계하는 문제입니다.
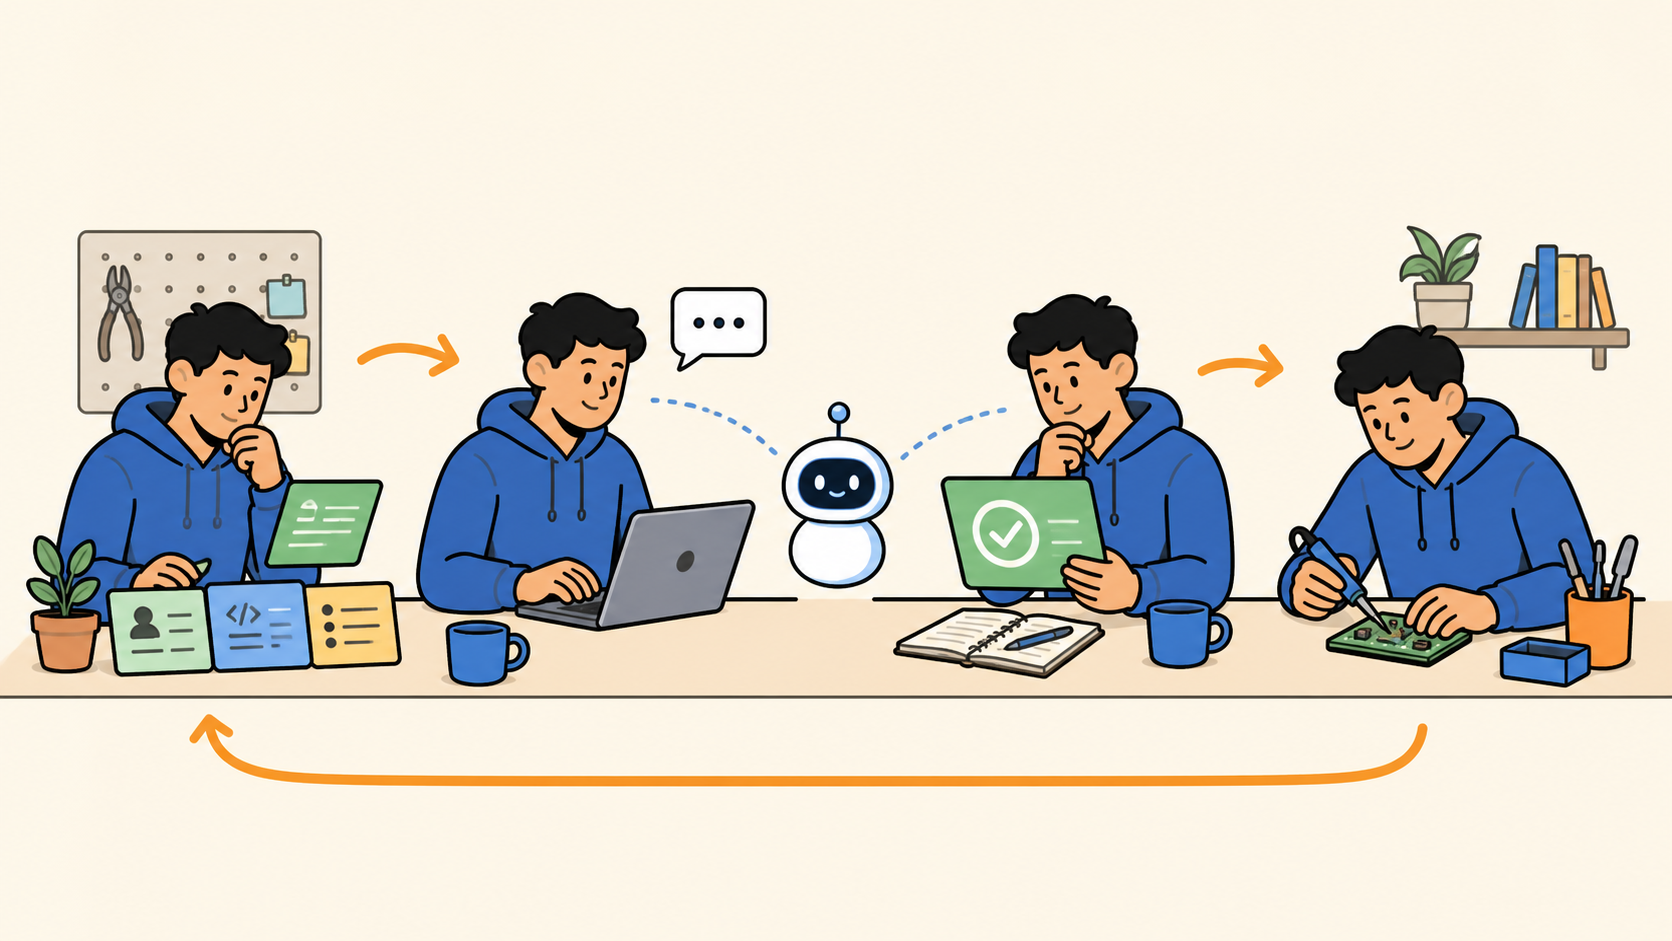
좋은 AI 도구는 중요한 판단을 숨기지 않고 사람을 작업 흐름 안에 남겨둡니다.
제가 만들고 싶은 도구는 다음 네 가지를 작게라도 잘해야 합니다.
| 질문 | 설계 방향 |
|---|---|
| 에이전트는 무엇을 봐야 하는가 | 전체 기록이 아니라 작고 관련성 높은 안전한 맥락만 제공합니다. |
| 무엇을 바꿀 수 있는가 | 도구를 호출하기 전에 권한과 멈출 지점을 분명히 합니다. |
| 제대로 작동했는지 어떻게 아는가 | 말이 자연스러운지만 보지 않고 산출물·근거·검증 결과를 확인합니다. |
| 실패하면 어떻게 되는가 | 제한된 실패를 반환하고 사람이 작업을 복구할 수 있게 합니다. |
그래서 이후 Luthn과 Drig를 다루면서 처음의 “AI를 더 편하게 만들자”는 생각이 구체적인 경계로 바뀌었습니다. Luthn은 에이전트가 볼 수 있는 안전한 맥락과 보호된 원문을 나눕니다. Drig는 기획·개발 후 QA와 일반 제품 구현의 경계를 나눕니다. 이것이 모든 작업을 더 좋게 만든다는 뜻은 아닙니다. 어떤 부분을 이해하고 개선해야 하는지 보이게 해주는 장치입니다.
도구를 만들며 배운 것
첫째, 자동화가 많다고 편리해지는 것은 아닙니다. 기획·위임·재시도·요약을 길게 연결하면 사람이 확인해야 할 상태가 오히려 늘어납니다. 작은 작업에는 좁은 도구 범위와 짧은 피드백 루프가 더 잘 맞을 때가 있습니다.
둘째, 기억에는 권한이 필요합니다. 선호나 프로젝트 결정을 기억하는 일은 유용하지만, 그 기록이 어디에서 왔고 누가 볼 수 있으며 언제 더 이상 유효하지 않은지 설명할 수 있어야 합니다. 메모리 서비스에 연결됐다는 사실만으로 뒤의 모든 기록을 읽을 권한이 생기지는 않습니다.
셋째, 하네스는 제품의 일부입니다. 모델·프롬프트·도구·맥락·재시도 정책·검증기가 함께 결과를 만듭니다. 조건이 숨겨져 있으면 성공을 재현하기 어렵고 실패 원인도 찾기 어렵습니다.
이 내용은 이 블로그에서 공개한 개발 작업을 바탕으로 한 관찰이지, 통제된 생산성 실험의 결과는 아닙니다. 어떤 구조나 모델이 모든 팀에 이긴다고 주장하지 않습니다. 맥락·권한·근거·복구를 보이게 만들수록 도구가 실제로 더 유용해진다는 좁은 판단입니다.
이 블로그에 남길 기록
앞으로는 완성된 화면만 보여주지 않겠습니다. 근거를 확보할 수 있다면 환경과 시점, 실제로 한 일, 결과, 실패나 예상과 달랐던 점, 결론의 적용 범위를 함께 기록하겠습니다. 근거가 부족하면 출처의 주장이라고 표시하거나 아직 답하지 못한 질문으로 남기겠습니다.
AI가 편해지는 이유는 불확실성을 숨겨서가 아니라 주변 작업이 분명해지기 때문이어야 합니다. 도구는 작게 시작하더라도 사람이 확인할 수 있는 결과와 스스로 고를 수 있는 다음 단계를 남겨야 합니다.