AI 코딩 workflow를 만들 때 흔히 하는 실수는 요구사항 해석부터 구현, 테스트, 리뷰, 병합 승인까지 모델 하나에게 맡기는 것입니다. 작은 작업에서는 편합니다. 하지만 일이 커지면 context가 길어지고, 무엇이 실패했는지와 누가 어떤 판단을 했는지 추적하기 어려워집니다.
제가 택한 답은 에이전트를 최대한 늘리는 것이 아닙니다. 사람이 확인할 수 있는 경계를 역할마다 정하는 것입니다. 중요한 질문은 “모델이 몇 개 실행되는가?”가 아니라 “이 역할은 무엇을 판단하고, 무엇을 바꾸고, 어디에서 멈추는가?”입니다.
역할표는 직접 확인할 수 있어야 합니다
현재 공개된 Drig lifecycle은 이 구분을 구체적으로 보여줍니다. 모델이 판단하는 stage와 시스템이 계약을 강제하는 stage를 따로 이름 붙입니다.
| 단계 | Drig에 기록된 경로 | 책임 |
|---|---|---|
ideaInterview |
gpt-5.6-terra / high |
막히는 범위 공백만 확인 |
internalPlan |
gpt-5.6-sol / high |
승인된 맥락을 제한된 plan으로 변환 |
| 개발과 checkpoint | gpt-5.6-sol / high |
범위가 정해진 slice를 구현하고 증거를 남김 |
codeReview |
gpt-5.6-sol / high |
immutable checkpoint를 검토 |
| QA revision 1·2 | gpt-5.6-luna / max |
남은 요구사항과 evidence를 확인 |
| routing·validation·publication·closeout | 모델 경로 없음 | 결정론적 계약을 강제 |
모델 이름은 바뀔 수 있습니다. 오래 남는 원칙은 경로가 명시되어 있다는 점입니다. Drig는 model-route --stage <stage> 명령으로 stage별 경로를 확인하게 하고, 정책이 없는 stage에 기본 모델을 조용히 배정하지 않고 fail-closed합니다.
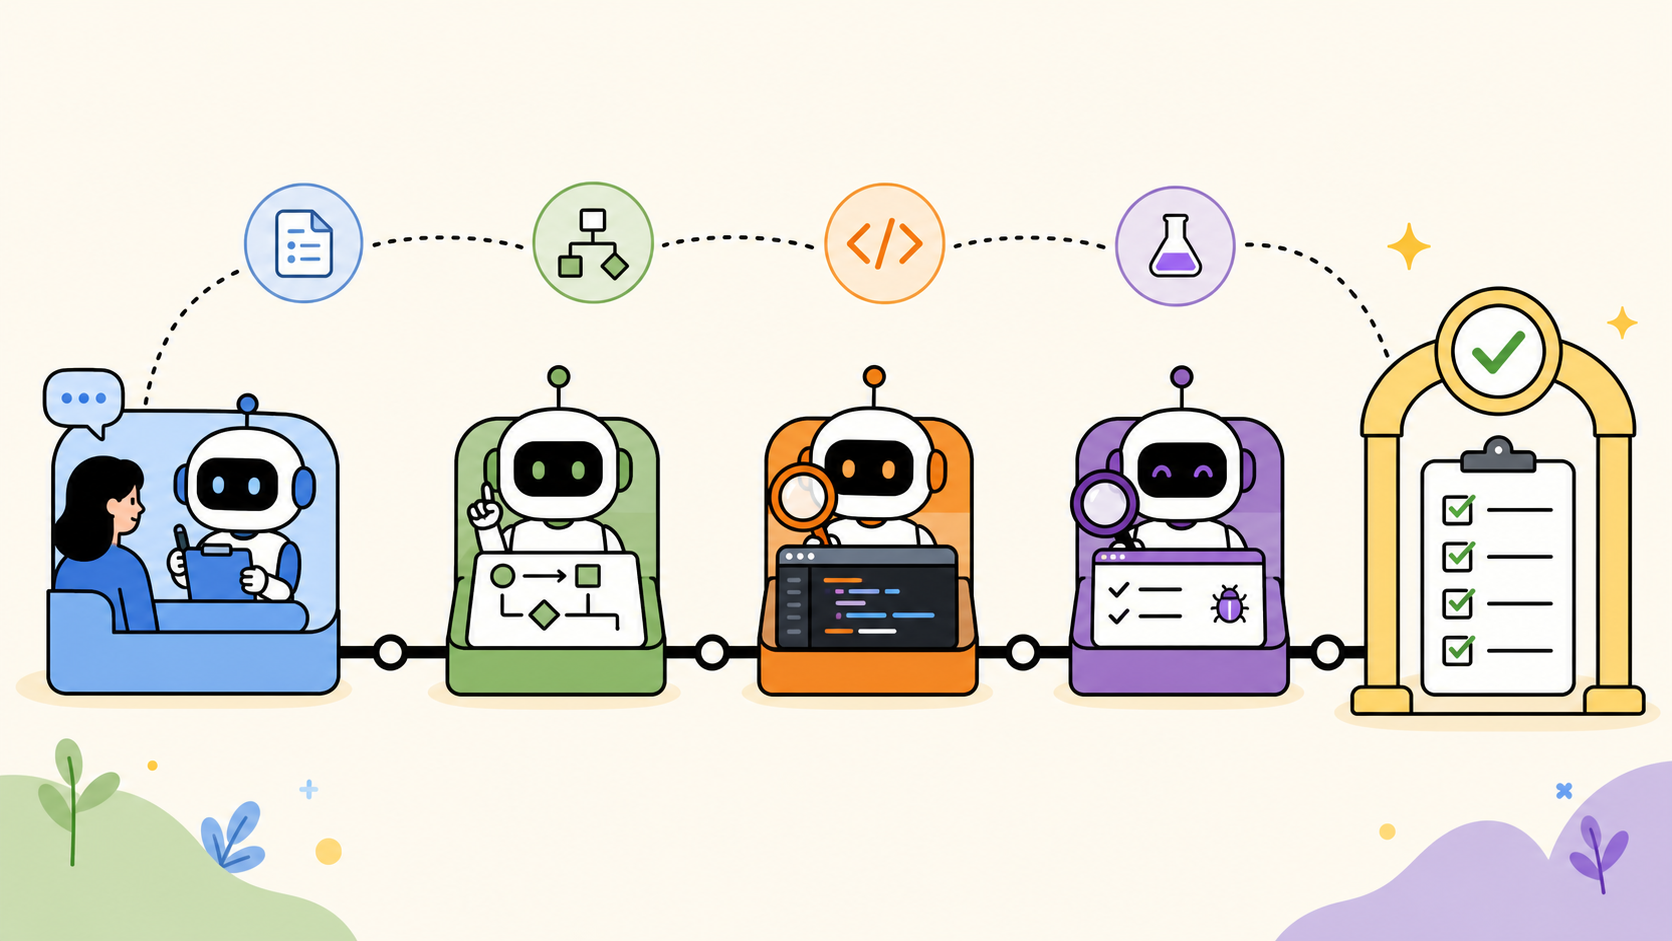
에이전트 수보다 중요한 것은 역할의 경계입니다.
역할에는 권한과 멈춤 지점도 들어갑니다
역할 이름만 정한다고 충분하지 않습니다. 무엇을 할 수 있는지와 어디에서 멈춰야 하는지도 함께 정해야 합니다.
구현 역할은 맡은 slice를 수정하고 필요한 검사를 실행한 뒤 local checkpoint를 남길 수 있습니다. 하지만 자기 코드가 곧 최종 승인이라고 선언해서는 안 됩니다. 리뷰 역할은 변경을 읽고 finding을 남길 수 있지만, 그 과정에서 제품 코드를 몰래 고쳐서는 안 됩니다. QA 역할은 acceptance criteria와 제한된 evidence를 받아야지, 이전 대화 전체를 무제한으로 전달받아서는 안 됩니다.
그래서 Drig lifecycle은 checkpoint마다 durable slice worktree를 두고, checkpoint별 native review를 실행하며, requirements QA에는 evidence manifest를 전달합니다. 최종 publication과 merge 결정은 코드를 작성한 모델과 분리됩니다. 한 agent가 자기 결과를 스스로 성공으로 선언하는 것보다 느리지만, 잘못된 결과가 어디에서 생겼는지는 더 쉽게 찾을 수 있습니다.
작은 작업은 작게 남겨야 합니다
역할을 나누는 것이 성숙함의 증거는 아닙니다. 파일 하나를 고치는 되돌릴 수 있는 작업이라면 Codex session 하나와 직접 테스트만으로 충분할 수 있습니다. 그런 작업을 기획·구현·리뷰·QA agent로 나누면 유용한 경계는 생기지 않고 handoff만 늘어납니다.
다음 조건 중 하나가 실제로 존재할 때만 두 번째 역할을 추가합니다.
- 별도의 permission set이 필요한가?
- 변경을 작성하지 않은 process가 acceptance criteria를 확인해야 하는가?
- durable contract를 만들 만큼 작업이 반복되는가?
- chat을 다시 읽지 않고 checkpoint에서 실패를 재개해야 하는가?
- publication이나 merge 전에 owner의 별도 승인이 필요한가?
하나도 해당하지 않는다면 추가 모델은 절차를 위한 절차일 가능성이 큽니다.
하네스를 가볍게 만든 뒤에도 남긴 것
무거운 wrapper는 걷어내고, 역할별 context·명시적인 model routing·집중된 workspace·다른 역할이 읽을 수 있는 evidence는 남겼습니다. 그래서 현재 Drig plugin은 같은 작업을 끝내려는 자율 agent 모음이 아닙니다. 일반 Codex가 제품 개발을 맡고, 주변 stage가 기획·리뷰·QA·배포를 보이게 만드는 workflow입니다.
이 구조는 모델을 평가하는 방식도 바꿉니다. 코드를 잘 쓰는지만 보지 않습니다. 맡은 slice 안에 머무는지, 쓸 만한 checkpoint를 남기는지, validator에 반응하는지, 역할이 끝났을 때 멈추는지를 봅니다. 구현 모델이 강하더라도 잘못된 확신을 유도한다면 QA 모델로는 맞지 않을 수 있습니다.
이 구조가 해결하지 못하는 것
역할을 나눈다고 workflow가 자동으로 올바르게 되지는 않습니다. stage가 늘어나면 시간과 context 비용도 늘어납니다. acceptance criteria가 잘못되어 있으면 아주 꼼꼼하게 검증해도 잘못된 결과를 확인하게 됩니다. 모델 경로가 명확해도 선택 자체가 나쁠 수 있습니다.
역할 구조가 해주는 일은 실패가 나타날 장소를 마련하는 것뿐입니다. 하지만 그 정도면 다음 변경을 더 신중하게 만들 수 있습니다. 목표는 더 큰 agent 팀이 아닙니다. 요청부터 마지막 evidence까지 사람이 설명할 수 있는 작은 책임 집합입니다.
이것이 제가 Nested Codex라고 부르는 원칙입니다. 모델 하나로 충분한 작업에는 하나만 사용합니다. 독립된 경계를 만들 때만 역할을 추가하고, 시작할 때부터 그 모델·권한·evidence·멈춤 지점을 보이게 합니다.